Updated at : Thu Oct 22 2026
이 포스팅은 AWS Skill Builder의 AWS Developer 과정을 학습하며 남긴 기록입니다.
이 단락에서는 data를 추가하는, 즉 DynamoDB의 기초적인 개념과 그 사용방법에 대해 다루고 있다. 그러나 매우 기본적인 내용을 다루며 코드를 직접 제공하여 실습하는 내용이 주를 이루고 있기에, 이를 굳이 기록하고 싶은 마음이 들지 않는다. 따라서 중요하다고 생각되는 것들만 몇 가지 기록하는 것으로 끝내도록 하겠다.
DynamoDB Fundamentals
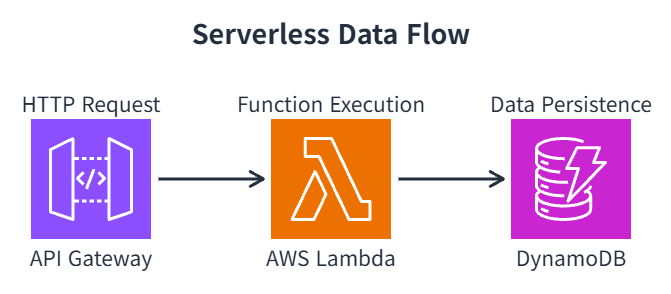
Why DynamoDB matches your serverless architecture?
AWS에서 severless 디자인을 소개할 때, 위와 같은 서비스들을 언급하며 dynamodb는 그 중 하나를 맡고 있다. 그런데 어째서 dynamodb가 severless 아키텍쳐에 적합하기에 추천하는 것일까? 그 이유로 dynamodb는 다음과 같은 특성 갖고 있기 때문에 적합하다고 얘기한다.
- Automatic scaling: Handles traffic spikes without capacity planning or performance degradation
- Consistent performance: Delivers single-digit millisecond response times whether you have 100 products or 100 million
- Pay-per-request pricing: Costs scale with actual API usage, not idle database capacity
- Zero server management: No patching, backups, or maintenance windows that could impact your API availability
- Built-in redundancy: Automatically replicates data across multiple Availability Zones for high availability
주관적으로 부연하자면, 나는 severless 디자인에서 가장 좋은 장점으로 빠른 개발, 자동 관리, 비용 최적화를 꼽는다. 람다 함수는 별다른 설정 없이도 수천개까지 자동으로 동시 실행 가능하다. API 게이트웨이도 급작스러운 트래픽 급증에 알아서 대처해 준다. 이것들과 함께 발맞출 수 있는 저장소가 필요한 것이다.
만일 이 환경에 기존 데이터베이스를 사용하면? 물론 대응할 수 있다. 하지만 사용량 계획, 서버 프로비저닝 등 직접 신경써야 하는 영역이 많아진다. 반면 dynamodb를 이용하면 그러한 운영관리를 신경쓰지 않고, 로직 개발만 하면 된다. 비용 문제도 크다. 기존 데이터베이스 사용을 위해 instance를 띄우면, 유지만으로 비용이 발생한다. dynamodb는? 사용한 만큼만 지불한다. 사용이 많지 않으면 사실상 무료다.
Table schema design
dynamodb는 primary(partition + sort) key를 활용해 테이블을 읽을 수 있다. 추가로 Secondary Index 설정을 통해 데이터를 읽을 수도 있다. 바꿔말하면 어떤 방식(key)으로 데이터를 읽을 것인지 결정하는 것이 가장 중요한 설계 요소이며, 이는 제작할 앱에서 어떤 접근이 있을 것인지 분석/예측함으로 알아내야 한다. 아래의 좀 더 상세한 내용들을 참조하자.
- Identify all access patterns first: List every query your application needs before designing tables
- Avoid scan operations: Scans read entire tables and become prohibitively expensive at scale
- Use composite keys strategically: Combine partition and sort keys to support range queries and hierarchical data
- Plan for secondary indexes: GSIs support additional query patterns but add cost and complexity
- Model for your queries: Denormalize data and duplicate attributes to optimize for read patterns
Data Operations
실제 코드와 함께 실습하는 단계로 기록하지 않으려 하였으나, 좋은 예시가 하나 보여 이는 기록한다.
Handling concurrent updates with optimistic locking
많은 요청이 동시다발적으로 들어온 경우 이를 해결하는 하나의 방법이다. 다음과 같은 상황이 있다고 하자.
- User A reads product with price $100
- User B reads same product with price $100
- User A updates price to $120
- User B updates price to $150 (overwrites User A's change)
이 경우 사용자 A의 업데이트는 손실되게 된다. 다음은 이 현상을 방지하기 위해 테이블에 version과 같은 속성 하나를 추가해 활용하는 방법이다.
# python code

new_version = current_version + 1

update_expression = """SET attr = :attr,
    # update etc..
    version = :new_version"""

expression_attribute_values = {
    ':attr': attr,
    # update value etc..
    ':new_version': new_version,
    ':current_version ': current_version
}

table.update_item(
    Key={'id': product_id},
    UpdateExpression=update_expression,
    ExpressionAttributeValues=expression_attribute_values,
    ConditionExpression='attribute_exists(id) AND version = :current_version',
    ReturnValues='ALL_NEW'
)
위 로직은 조건(ConditionExpression)에 의해, 테이블에 현재 기록된 version이 로직을 실행하던 당시 알고 있던 version과 같은게 맞는지 검사하게 된다. 이를 활용하면 앞선 예시는 아래와 같이 변경된다.
- 요청 A, B가 동시다발적으로 발생. 요청 A, B 모두 동일한 version 값으로 업데이트 시도
- 요청 A 처리 진행 => 업데이트 성공
- 요청 B 처리 진행 => 요청 A에 의해 version이 변경된 상황 => 업데이트 실패